
Jika teks-ke-video adalah yang terbaik untuk penerokaan, imej-ke-video adalah yang terbaik untuk kawalan.
Itulah cara paling mudah untuk menentukan masa untuk menggunakan Seedance 2.5 imej-ke-video. Aliran kerja memberikan model penambat visual, yang memudahkan untuk mengekalkan identiti subjek, bentuk produk, butiran pakaian, logik pembingkaian dan komposisi keseluruhan.
Bagi pencipta yang memerlukan hasil yang lebih boleh diramal, ini selalunya berdegup bermula daripada gesaan kosong.
Jika anda ingin membandingkan dua pendekatan sebelum menjana, mulakan dengan gambaran keseluruhan tentang Seedance 2.5 Panduan Model dan kemudian uji aliran kerja anda sendiri dalam C Dance Ruang Kerja AI dengan imej-ke-video dan Seedance 2.5 dipilih.
Apabila Imej-ke-Video Mengalahkan Teks-ke-Video
Gunakan imej-ke-video apabila mana-mana perkara ini:
- reka bentuk muka atau watak mesti kekal dikenali
- bentuk produk mesti kekal konsisten
- gubahan sudah berfungsi dan hanya memerlukan gerakan
- anda ingin menghidupkan seni utama, fotografi atau bingkai konsep
Teks-ke-video adalah lebih baik untuk ciptaan. Imej-ke-video adalah lebih baik untuk pemeliharaan.
Seedance 2.5 struktur gesaan yang bertahan
Mulakan dengan subjek yang boleh dilihat, kemudian terangkan tindakan, tindak balas persekitaran, kamera, bunyi dan keadaan penamat. Pesanan ini memastikan gesaan terikat pada perkara yang model boleh tunjukkan atau dengar. Ia juga memudahkan semakan: jika muka hanyut, tukar kekangan subjek; jika kamera merayau, tukar baris kamera; jika klip berakhir tanpa rentak, tukar keadaan akhir.
Gunakan templat berfungsi ini:
Subjek: [siapa atau apa yang kelihatan dalam bingkai pembukaan]
Tindakan: [satu tindakan utama dengan permulaan dan penghujung yang jelas]
Persekitaran: [apa yang bergerak, bertindak balas atau diam]
Kamera: [saiz tangkapan, pergerakan, kelajuan dan sudut]
Audio: [dialog, bunyi fizikal, suasana atau muzik]
Penamat: [pose akhir, bingkai atau peralihan]
Kekangan: kekalkan [identiti, bentuk produk, teks atau komposisi]
Templat bukan formula ajaib. Ia adalah senarai semak yang menghalang kesilapan biasa: menghabiskan sebahagian besar gesaan pada perkataan mood sambil membiarkan gerakan sebenar menjadi samar-samar.
Contoh teks-ke-video: satu tindakan, satu gerakan kamera
Untuk kanvas kosong, tentukan bingkai pertama sebelum meminta gerakan. Gesaan yang boleh digunakan untuk klip landskap pendek kelihatan seperti ini:
Seorang penunggang basikal berseorangan menunggu di sebelah basikal jalan merah di jalan gunung yang basah sebelum matahari terbit. Penunggang basikal memeriksa roda hadapan, memasang dan menunggang ke hadapan melalui tompokan air yang cetek. Kamera bermula dalam profil sisi sederhana, menjejak selari selama tiga saat, kemudian membuat satu tolakan perlahan ke arah penunggang apabila jalan berbelok ke kiri. Semburan air dari tayar dan mendap di belakang basikal. Pastikan jaket merah penunggang, rangka basikal dan arah jalan raya konsisten. Tayar semula jadi dan bunyi air, tiada dialog. Berakhir pada penunggang basikal meninggalkan bingkai sementara jalan dan langit pucat kekal kelihatan.
Gesaan ini mempunyai satu tindakan utama dan satu perubahan kamera. Jika keputusan terlalu sibuk, keluarkan tolak masuk sebelum menukar perihalan subjek. Menukar beberapa dimensi sekaligus menjadikan generasi seterusnya sukar untuk didiagnosis.
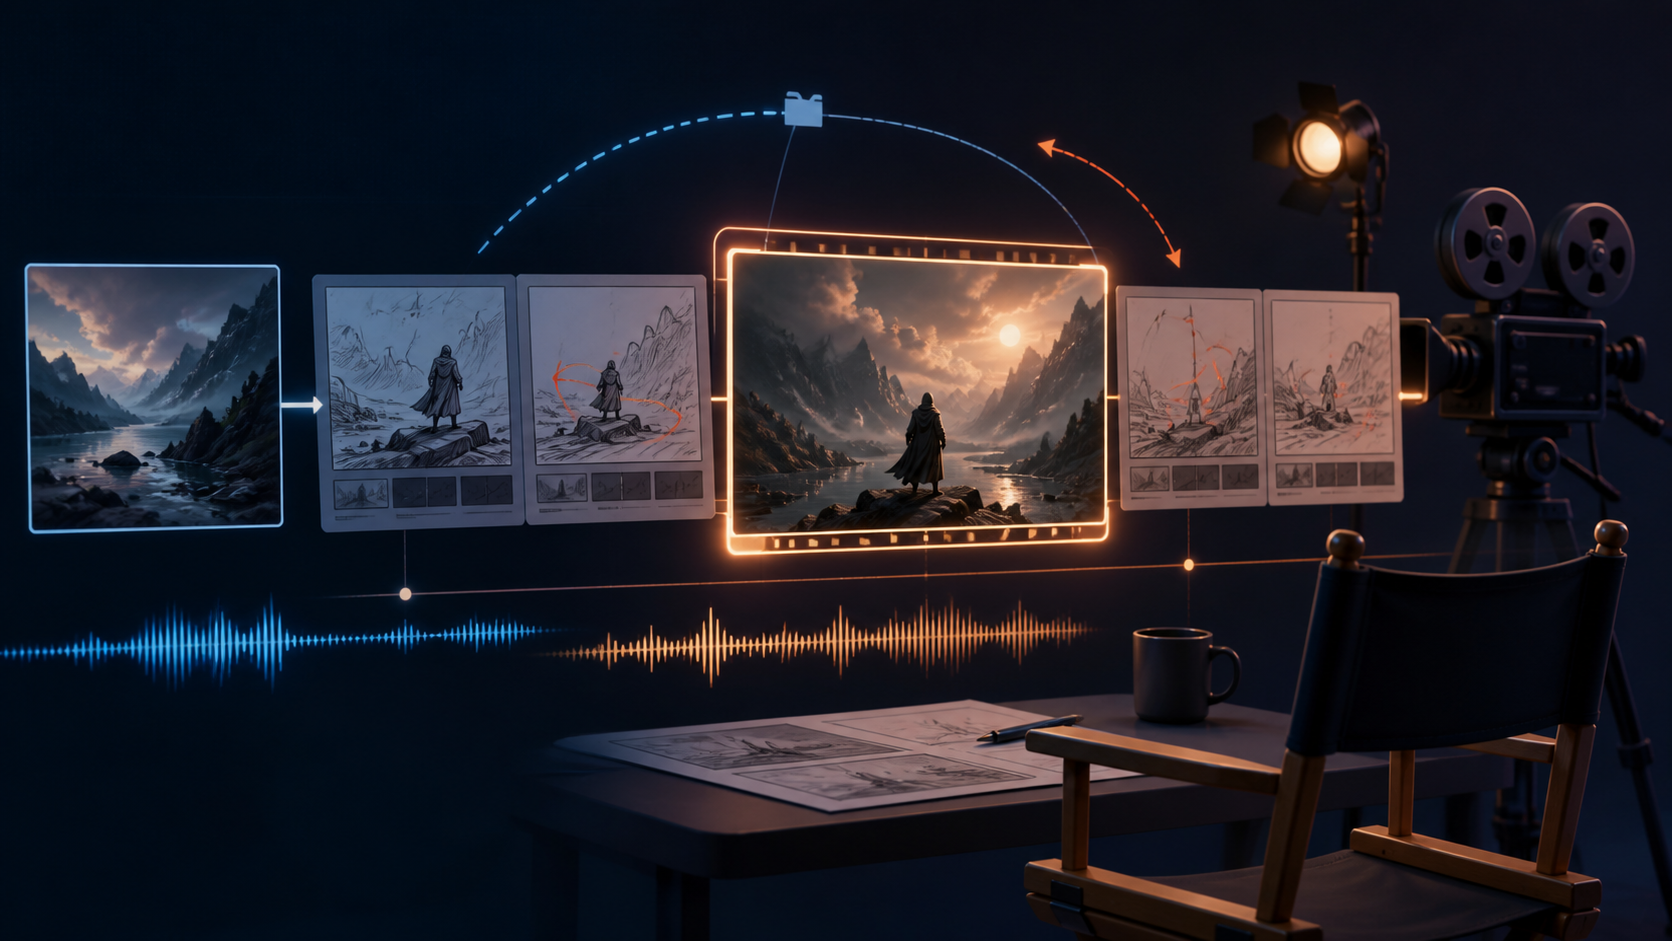
Contoh imej-ke-video: huraikan perubahan, bukan imej
Apabila imej sumber sudah mengandungi subjek dan gubahan, ulang hanya butiran yang mesti kekal tetap. Gunakan gesaan untuk menerangkan perkara yang berlaku selepas bingkai satu:
Animasikan gambar produk yang dibekalkan. Pastikan label botol, penutup, bentuk kaca, kedudukan atas meja dan lampu sisi hangat tidak berubah. Reben nipis pemeluwapan terbentuk pada botol dan dua titisan bergerak ke bawah. Kamera membuat lengkok mengikut arah jam yang sangat kecil, kurang daripada satu perempat pusingan, sambil kekal pada ketinggian yang sama. Tambahkan paip kaca yang tenang dan suasana bilik. Tamat dengan botol berpusat dan boleh dibaca sepenuhnya.
Frasa "kekal tidak berubah" berguna apabila ia menamakan sifat visual konkrit. Ia kurang berguna apabila ia menjadi senarai panjang setiap piksel dalam imej. Pilih tiga hingga lima butiran yang penting kepada syot.
Gesaan berbilang tangkapan memerlukan cap masa
Untuk urutan dengan lebih daripada satu rentak, tulis senarai pukulan padat dan bukannya satu perenggan tindakan serentak. Berikan setiap tangkapan tempoh, pembingkaian, tindakan dan peralihan:
0-3s, pukulan lebar: seorang tukang roti membuka kedai kecil pada waktu subuh dan menghidupkan papan tanda.
3-6s, pukulan sederhana: tepung naik semasa tukang roti menguli doh, kamera dikunci.
6-9s, jarak dekat: tukang roti memotong roti suam; wap melintasi latar depan.
9-12s, tarik balik perlahan: pelanggan pertama masuk, loceng berbunyi, tamat di kaunter yang sibuk.
Pastikan identiti subjek dan lokasi konsisten merentasi baris. Jika model mencipta ruang baharu di antara tangkapan, tambahkan satu sauh yang dikongsi seperti "kedai roti sempit yang sama dengan jubin biru dan tingkap hadapan". Jangan selesaikan masalah kesinambungan dengan menambah lebih banyak kata sifat pada setiap pukulan.
Arahan audio yang mudah untuk diuji
Asingkan dialog, bunyi fizikal, suasana dan muzik. Namakan pembesar suara sebelum baris yang tepat, dan biarkan masa yang cukup untuk baris itu selesai. Contohnya:
Dialog: wanita berkot kuning berkata, "Kereta api sudah ada di sini."
Bunyi fizikal: satu brek kereta api memekik dan tapak kaki di platform.
Suasana: rungutan stesen rendah dan pengumuman jauh.
Muzik: tiada muzik latar belakang.
Pemisahan ini juga menjadikan kegagalan audio lebih mudah untuk diklasifikasikan. Jika pertuturan salah tetapi pergerakan itu boleh digunakan, kekalkan gesaan visual dan semak semula baris dialog sahaja. Jika setiap bunyi bersaing dengan suara, alih keluar muzik dahulu.
Lima kegagalan Seedance 2.5 biasa
Subjek bergerak sebelum tangkapan ditetapkan
Buka dengan penerangan statik untuk rentak separuh saat pertama atau pertama. Ini memberikan model titik permulaan visual sebelum tindakan bermula.
Kamera melakukan terlalu banyak pergerakan
Gunakan satu gerakan kamera utama setiap tangkapan. "Dolly masuk semasa mengorbit, menyengetkan, mengezum dan goncangan pegang tangan" ialah permintaan untuk beberapa trajektori yang bersaing. Pilih langkah yang menyokong cerita dan simpan yang lain untuk tangkapan lain.
Hasil imej-ke-video melukis semula rujukan
Nyatakan butiran yang dilindungi dan huraikan perubahan sahaja. Kurangkan amplitud gerakan, kemudian keluarkan kesan sekunder seperti zarah, pantulan atau perubahan pencahayaan dramatik.
Dialog tamat terlalu lewat
Pendekkan baris, mula bercakap lebih awal, atau tambahkan tempoh tangkapan apabila antara muka membenarkannya. Jangan tambahkan "cakap lebih pantas" pada gesaan yang sudah ramai; yang sering mencipta penyampaian yang tidak wajar.
Pengakhirannya terasa belum selesai
Tulis keadaan akhir secara eksplisit. Subjek boleh meninggalkan bingkai, berhenti dalam pose, mendedahkan produk atau kembali ke komposisi pembukaan. Tanpa penamat, model mungkin menghabiskan saat akhir meneruskan tindakan tengah.
Gelung lelaran boleh berulang
Hasilkan hantaran pertama yang mudah, kemudian tukar satu pembolehubah pada satu masa. Mula-mula semak identiti dan komposisi subjek. Seterusnya semak sama ada tindakan utama selesai. Kemudian semak laluan kamera, audio dan bingkai akhir. Simpan gesaan terbaik di sebelah hasil dan rekod model, tempoh, nisbah bidang dan versi imej sumber yang tepat. Nota tersebut lebih berguna daripada penilaian yang samar-samar bahawa satu generasi "kelihatan lebih baik."
Ruang kerja AI C Dance awam membolehkan anda menguji gesaan yang sama dengan Seedance 2.5 dipilih dalam laluan teks-ke-video. Untuk aliran kerja rujukan, gunakan Halaman model Seedance 2.5, buka ruang kerja Seedance 2.5 diprapilih dan bandingkan hasilnya dengan panduan imej-ke-video Seedance 2.0 dan panduan papan cerita berbilang syot Seedance 2.0 kami.
Seedance 2.5 Soalan Lazim segera
Adakah Seedance 2.5 lebih baik dengan gesaan yang panjang?
Gesaan yang lebih panjang hanya membantu apabila setiap baris menambah kekangan yang boleh dilihat atau boleh didengar. Gesaan pendek dengan satu tindakan yang jelas selalunya lebih mudah dikawal daripada perenggan panjang yang mengandungi beberapa peristiwa yang tidak berkaitan.
Patutkah saya menggunakan teks-ke-video atau imej-ke-video?
Gunakan teks-ke-video apabila anda memerlukan model untuk mencipta adegan. Gunakan imej-ke-video apabila bingkai pertama sudah mempunyai subjek, reka letak, produk atau reka bentuk aksara yang anda ingin simpan.
Berapa banyak gerakan kamera yang harus terkandung dalam satu gesaan?
Mulakan dengan satu gerakan kamera utama setiap tangkapan. Tambahkan langkah kedua hanya apabila senarai tangkapan jelas memisahkan masa dan peralihan.
Bagaimanakah saya memastikan produk boleh dibaca?
Namakan label, bentuk, kedudukan dan pencahayaan sebagai butiran yang dilindungi. Pastikan pergerakan produk kecil dan akhiri dengan bingkai yang stabil. Teks kecil mungkin masih gagal, jadi layan klip yang dijana sebagai draf sehingga anda memeriksanya pada saiz penuh.
Bolehkah saya menggesa dialog dan muzik bersama-sama?
Ya, tetapi tetapkan setiap satu hubungan peranan dan kelantangan. Jika dialog ialah mesej, katakan bahawa ia kekal boleh difahami dan kurangkan atau alih keluar muzik semasa talian.
Adakah panduan ini menjamin hasil tertentu?
Tidak. Contoh adalah titik permulaan berstruktur, bukan penanda aras terkawal. Keputusan bergantung pada imej sumber, gesaan, versi model, tempoh dan tetapan antara muka yang tersedia pada masa penjanaan.
Peraturan praktikalnya mudah: tentukan bingkai, minta satu tindakan yang boleh dibaca, kawal kamera dan berikan klip di suatu tempat untuk ditamatkan. Kemudian uji perubahan seterusnya dalam pengasingan.
Itulah sebabnya banyak pasukan komersial menggunakan teks-ke-video untuk idea dan imej-ke-video untuk penghalusan.